산업 현장의 데이터를 실행으로 잇는 AI 에이전트
현장 데이터를 읽고 판단과 실행 권고까지 잇는 산업 AI 엔진을 루넥시오가 어떤 원칙으로 설계하는지 정리했습니다.
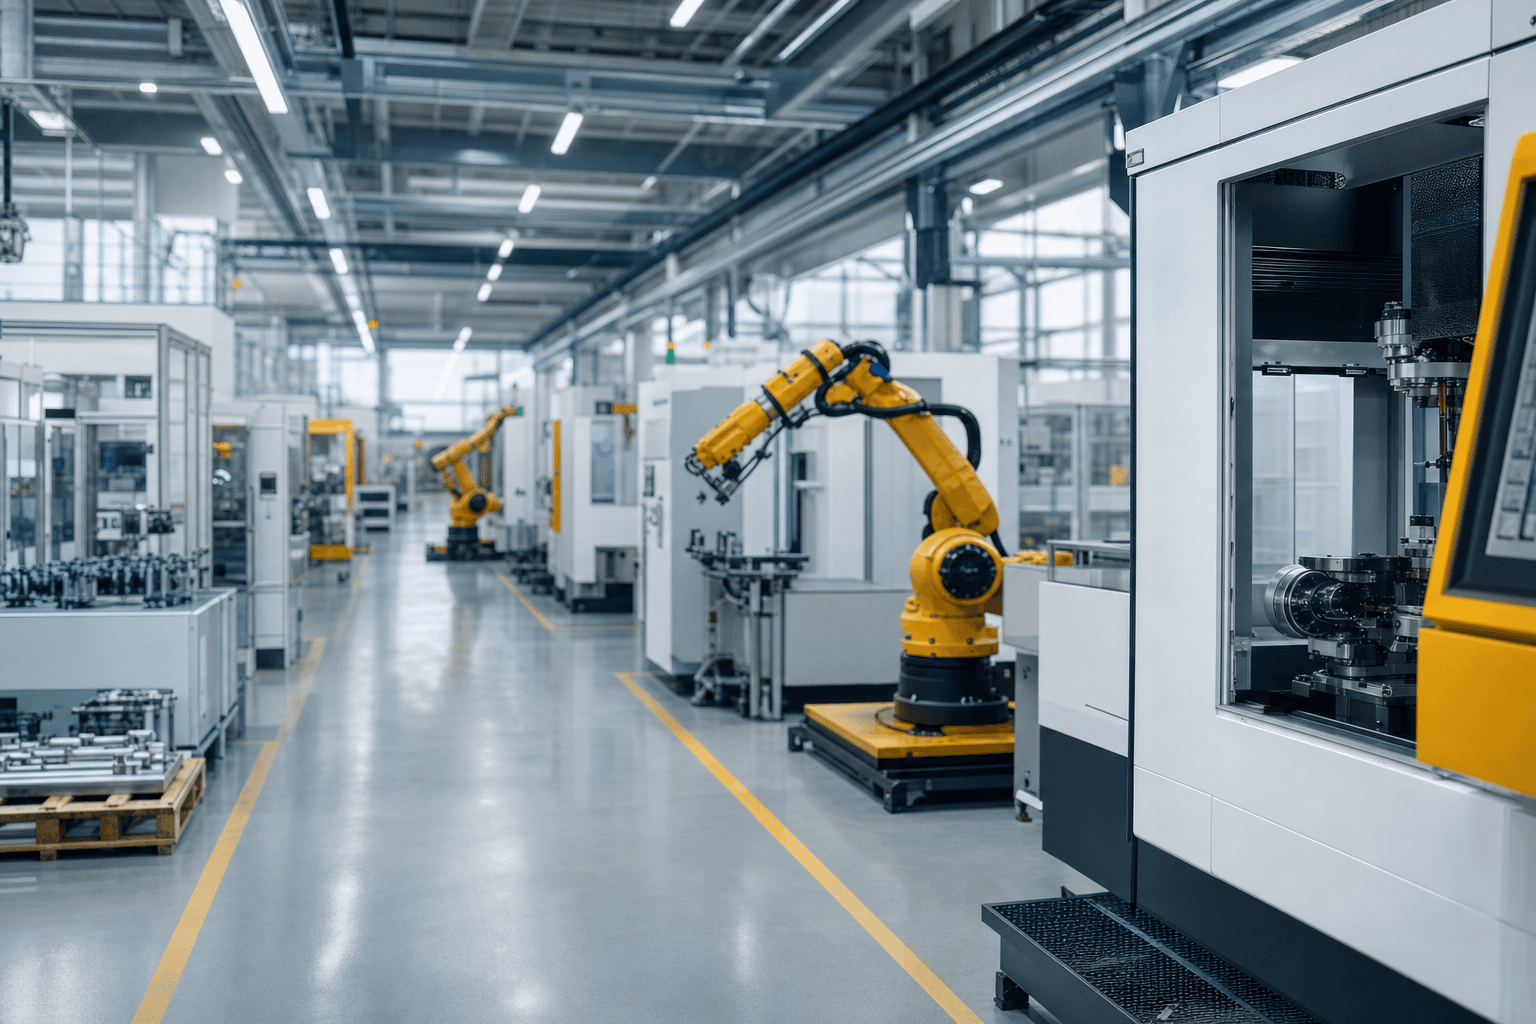
제조·엔지니어링 현장에는 설계와 해석, 공정, 검사 데이터가 매일 쌓입니다. 이 데이터가 부서와 프로젝트마다 흩어져 있으면 다음 의사결정에 쓰이지 못한 채 남는 경우가 많습니다. 루넥시오가 산업 AI를 설계할 때 출발점으로 삼는 문제입니다.
예측값만으로는 현장이 움직이지 않습니다
AI가 예측값을 내놓아도 그 값을 공정 조건에 반영하고 문서로 남기는 일은 대개 사람이 맡습니다. 시계열과 비전, 언어 데이터를 따로 학습한 모델이 현장에서 서로 맞지 않는 결과를 내기도 합니다. 범용 LLM은 제조 현장에서 수치 오류나 사실과 다른 답을 낼 위험도 있습니다.
루넥시오는 도메인 지식과 물리 기반 모델을 결합해 감지와 판단, 실행 권고까지 하나의 흐름으로 잇는 산업 AI 엔진을 만듭니다.
네 가지 설계 원칙
Domain-Knowledge-based
공정의 물리 법칙과 산업별 기준을 알고리즘에 먼저 반영합니다. 데이터가 충분히 쌓이기 전인 초기 적용 단계에서도 판단 근거를 낼 수 있도록 하기 위해서입니다. 산업 현장은 데이터만으로 설명하기 어렵고, 공정 원리와 설비 특성을 함께 봐야 현장에 맞는 결과가 나옵니다.
Explainable
결과마다 왜 이 값인지 근거를 함께 제시합니다. 현장 엔지니어가 결과를 검토하고 직접 실행하려면 근거가 보여야 합니다.
On-Premise Ready
설계와 공정, 품질 데이터는 기업의 핵심 기밀입니다. 고객사 내부망 운영과 On-Premise 구축 옵션을 제공해 핵심 데이터를 회사 안에 둔 채 AI를 운영할 수 있게 합니다.
Modular Engine
Forecast, Vision, Edge, Control, Quality, Simulation, Assist, DocFlow처럼 기능별 모듈로 엔진을 나눴습니다. 고객 과제에 필요한 모듈만 골라 조합해 한 영역에서 시작하고, 단계적으로 범위를 넓힐 수 있습니다.
에이전트가 수치를 다루는 방식
문서와 수치를 다루는 에이전트에서는 오류를 걸러 내는 장치가 중요합니다. 루넥시오는 데이터를 추출하는 Extractor Agent와 추출 결과를 원본과 대조해 검수하는 Critic Agent를 나눠 이중으로 교차 검증하고, JSON 스키마로 출력 형식을 제한합니다. 추출한 텍스트와 수치에는 원본 문서의 ID와 페이지 번호, 문서상 위치 정보를 연결해 감사 요청이 들어오면 근거를 바로 보여 줄 수 있습니다. 이 방식은 GMP 문서 자동화 사례에 적용했습니다.
형태가 다른 데이터를 하나의 엔진에서
현장 데이터는 형태가 제각각입니다. 루넥시오는 센서 시계열과 3D 도면, 비정형 문서를 밀리초 단위로 동기화하는 단일 엔진을 개발했습니다. 시계열과 비전, 언어 데이터를 한 흐름 안에서 함께 다루기 위한 기술입니다.
솔루션에 적용된 모습
이 원칙은 사출기 안에서 조건을 보정하는 Proteus AI, 과거 해석 데이터를 다시 쓰는 Janus AI, 근거와 함께 GMP 문서를 만드는 문서 자동화까지 루넥시오 솔루션 전반에 들어가 있습니다. 산업별 적용 내용은 적용 사례에서 볼 수 있습니다.